Jev na Prática: Triagem Inteligente de Atendimento de Cartão de Crédito
Como o Jev julga, com segurança, o que fazer com um chamado de suporte bancário, e por que a decisão final continua sendo do seu código


Todo banco com operação de cartão de crédito enfrenta o mesmo gargalo operacional: o cliente abre um chamado (o chip não é lido, a cobrança apareceu duplicada, o cliente contesta um lançamento) e alguém, ou algo, precisa decidir rapidamente o que fazer. Esse volume não escala com analistas humanos. E resolver isso jogando o chamado inteiro para uma IA genérica, pedindo de volta uma decisão de negócio pronta em texto livre, é imprudente: você estaria colocando um modelo probabilístico para tomar uma decisão financeira com efeito regulatório, sem controle, sem auditoria e sem previsibilidade.
É exatamente esse problema que o Jev, o modelo System One da TypeSafe usado aqui como camada de julgamento estruturado, foi desenhado para resolver. O Jev não devolve uma decisão pronta em texto livre: ele devolve respostas tipadas (noul, choice, score) para perguntas específicas e mensuráveis que eu formulo sobre um chamado, e deixa a decisão final para o código determinístico da minha aplicação. Essa separação, o Jev julga, o código decide, é o ponto central de tudo que segue.
Todos os exemplos de código abaixo são reais, não hipotéticos: vêm de um repositório de demonstração que integra o Jev via SDK TypeScript da TypeSafe (@typesafe-ai/sdk), aplicado a um cenário fictício: o SAC de cartão de crédito do Banco Aurora, com um cartão de duas categorias (Aurora Black e Aurora Classic). Cada trecho pode ser copiado e roda de verdade com npm run scenario <caminho-do-arquivo>.
Por que o Jev julga, mas não decide
Um erro comum ao integrar o Jev é tentar usá-lo como se fosse uma caixa que recebe um chamado e devolve uma decisão de negócio pronta ("emitir segunda via", "negar", "escalar"), jogando fora exatamente a garantia que o noul/choice/score tipados oferecem. Deixar essa decisão de negócio para uma resposta aberta, em vez de compor várias perguntas tipadas ao Jev, tem três problemas sérios num contexto bancário:
Primeiro, a decisão vira opaca. Se um auditor do Banco Central perguntar por que um estorno foi negado automaticamente, "o Jev achou que sim" não é uma resposta aceitável; mas "o Jev retornou o julgamento X com confidence 0.95, e a regra Y exige 0.9" é.
Segundo, a lógica de negócio fica presa dentro do prompt. Toda vez que a política de risco mudar (e ela muda com frequência em compliance bancário), você precisa reescrever e revalidar um prompt inteiro, em vez de alterar uma regra em código versionado e testável.
Terceiro, você perde a capacidade de compor sinais. Uma decisão real de atendimento combina o julgamento do Jev com dados que o sistema já possui: categoria do cartão, tempo de emissão, quantidade de chamados anteriores, se o cartão já foi bloqueado por suspeita. Se peço ao Jev para decidir tudo de uma vez, em uma pergunta só, não consigo misturar esses sinais com peso e transparência depois.
A forma correta de usar o Jev inverte esse instinto: ele não decide, ele julga proposições específicas, e o código decide com base nesses julgamentos combinados com as regras de negócio.
Parte 1: Preparação do Estado
Antes de perguntar qualquer coisa ao Jev, preciso decidir como representar o chamado. Essa etapa é subestimada, mas é onde a maior parte dos erros de julgamento nasce, porque um Jev mal alimentado produz um julgamento mal fundamentado, por melhor que seja a pergunta.
String simples versus objeto estruturado
Para um caso simples, uma string com o relato do cliente pode bastar: é o que 1-estado/01-chamado-cartao-com-defeito/001-texto-corrido.ts demonstra. Mas um chamado bancário real envolve múltiplos campos relacionados entre si: dados da emissão do cartão, canal de origem, benefícios do plano, mensagens trocadas com o atendimento. Nesse cenário, um objeto estruturado é a escolha correta, pelos mesmos motivos que valem para qualquer contrato de API: clareza semântica, testabilidade e persistência direta em banco de dados. É a diferença entre os dois arquivos da pasta 1-estado/01-chamado-cartao-com-defeito:
const state = {
  chamado: {
    assunto: "Cartão não é lido na maquininha",
    status: "aberto",
    canal: "app",
  },
  cliente: {
    nome: "Marina",
    cartao: "Aurora Black",
    beneficio_cartao:
      "Segunda via gratuita por defeito, dentro de 12 meses da emissão.",
  },
  emissao: {
    produto: "Cartão de crédito Aurora Black",
    anuidade_reais: 490,
    emitido: "3 semanas atrás",
  },
  mensagem:
    "Oi, peguei meu cartão Aurora Black há cerca de três semanas e ele parou de ser lido na maquininha. " +
    "A luz do chip nem acende, e já testei em duas maquininhas diferentes. Vocês conseguem me ajudar?",
};

const { answers } = await client.systemOne({
  state,
  questions: {
    cartaoComDefeito: noul("A `mensagem` descreve um cartão com defeito?"),
    cobertoPeloBeneficio: noul("A `emissao.produto` está coberta para uma segunda via gratuita pelo `cliente.beneficio_cartao`?"),
  },
});
Estruturação da conversa como array ordenado
Quando o chamado envolveu uma troca de mensagens com o atendimento, por exemplo, uma ligação, represento isso como um array ordenado, e não como um texto único concatenado. 1-estado/02-ligacao-com-pedido-de-estorno/003-fala-a-fala.ts leva isso ao extremo, marcando cada fala com quem a disse:
const state = {
  transcricao_ligacao: [
    { falante: "atendente", texto: "Central Aurora, aqui é a Sofia. Como posso ajudar?" },
    { falante: "cliente", texto: "Oi. Na verdade são duas coisas. Primeiro, eu me mudei no mês passado, preciso atualizar meu endereço." },
    // ...
    { falante: "atendente", texto: "Então eu tenho duas opções. Posso enviar uma segunda via para o seu novo endereço, ou estornar a anuidade integralmente." },
    { falante: "cliente", texto: "O que você faria?" },
    // ...
  ],
};
Isso preserva a cronologia e a alternância entre interlocutores, o que é determinante para o Jev entender, por exemplo, se o cliente mudou a versão do relato ao longo da ligação, um sinal de inconsistência potencialmente útil para investigação de fraude, não um julgamento de fraude isolado. Fraude real se decide com um conjunto de evidências muito maior (dispositivo, histórico de transações, estabelecimento, velocidade, localização, autenticação, histórico de chargebacks); o Jev contribui um sinal contextual para esse conjunto, nunca a conclusão.
Cálculo prévio no código, nunca no prompt
Qualquer valor que o código já consegue calcular deve chegar pronto ao Jev. Não delego ao Jev operações que são determinísticas: ele foi desenhado para julgar conteúdo não estruturado, não para fazer aritmética. Em 1-estado/03-cobertura-da-garantia-do-cartao/002-calculado-no-codigo.ts, a cobertura do benefício depende de quantos meses se passaram desde a emissão do cartão, e esse cálculo é feito em TypeScript puro, não descrito em linguagem natural para o Jev resolver:
function mesesEntre(de: string, ate: string) {
  const inicio = new Date(de);
  const fim = new Date(ate);
  return (fim.getFullYear() - inicio.getFullYear()) * 12 + (fim.getMonth() - inicio.getMonth());
}

const meses = mesesEntre(emitidoEm, "2026-09-26");

const { answers } = await client.systemOne({
  state: {
    cliente: {
      nome: "Marina Alves",
      cartao: "Aurora Black",
      beneficio_cartao: "Segunda via gratuita por defeito, dentro de 12 meses da emissão.",
    },
    emissao: { produto: "Cartão de crédito Aurora Black", emitido: `${meses} meses atrás` },
    mensagem: "Meu cartão parou de ser lido na maquininha. Vocês podem emitir uma segunda via?",
  },
  questions: {
    cobertoPeloBeneficio: noul("A `emissao.produto` ainda está coberta pelo `cliente.beneficio_cartao`?"),
  },
});
Isso reduz o espaço de erro do julgamento e reduz custo de tokens, porque não preciso descrever a regra de cálculo em linguagem natural toda vez que chamo o Jev.
Evitar ruído e dados desnecessários
1-estado/04-frustracao-no-historico-de-chamados/002-somente-chamado-atual.ts envia só o chamado atual do cliente para o Jev julgar frustração, não o histórico completo de atendimentos (esse é o objetivo do arquivo 001-historico-completo.ts, para comparação). Além do custo de tokens, informação irrelevante dispersa o julgamento do Jev. Envio apenas o que é funcionalmente necessário para as perguntas que vou fazer na próxima etapa. Isso também tem implicação direta de LGPD: quanto menos dado pessoal eu injeto no estado enviado ao Jev, menor a superfície de exposição, e isso deve ser tratado como requisito não funcional, não como boa prática opcional.
Parte 2: Formulação das Perguntas de Julgamento
Esta é a parte central de como uso o Jev. Em vez de uma pergunta aberta como "esse chamado é grave?", eu decomponho o julgamento em perguntas tipadas (as três formas que o Jev entende: noul, choice e score), cada uma com uma forma de resposta restrita que o código consegue consumir sem ambiguidade.
choice: quando existe exatamente uma resposta exclusiva
Uso choice quando as opções são mutuamente exclusivas e eu preciso de exatamente uma resposta. Em 2-perguntas/04-criterio-de-julgamento/004-criterio-estruturado.ts, cada opção carrega um critério estruturado (o que ela cobre, o que ela explicitamente não cobre, e exemplos) em vez de só uma frase:
time: choice("Qual time deve atender a `mensagem`?", {
  cobrancas: {
    covers: "Cobranças, fatura, contestação de lançamento ou estorno",
    not_for: "Enviar um cartão de volta ou solicitar uma segunda via",
    examples: ["Fui cobrado duas vezes", "Quando meu estorno chega?"],
  },
  emissao: {
    covers: "Emissão do cartão, entrega, segunda via ou status de envio",
    not_for: "O status de um estorno ou de uma cobrança",
    examples: ["Cadê meu cartão?", "Como peço uma segunda via?"],
  },
  acesso: { /* ... */ },
  funcionamento: { /* ... */ },
}),
Esse critério não é decoração. É onde eu defino explicitamente, para o Jev, o que cada categoria significa no meu domínio de negócio, incluindo o que ela não cobre. A comparação com 003-criterio-simples.ts, que usa só uma frase por opção, mostra o quanto essa estrutura reduz ambiguidade entre times parecidos. Sem esse detalhamento, o Jev aplica sua própria intuição sobre onde traçar a linha, que pode não coincidir com a organização real do banco.
noul: quando várias condições podem ser verdadeiras ao mesmo tempo
Uso perguntas noul independentes quando as condições não são mutuamente exclusivas. Um chamado pode simultaneamente pedir um supervisor e mencionar uma reclamação no Banco Central. 2-perguntas/03-sinais-de-escalonamento/002-sinais-separados.ts decompõe o julgamento de escalonamento em quatro sinais atômicos:
questions: {
  pedeSupervisor: noul("A `mensagem` pede para falar com um supervisor ou alguém mais sênior?"),
  ameacaCancelar: noul("A `mensagem` ameaça cancelar o cartão ou deixar de ser cliente?"),
  mencionaProconOuJudicial: noul("A `mensagem` menciona ação judicial, Procon ou reclamação no Banco Central (BACEN)?"),
  contatoRepetido: noul("A `mensagem` diz que o cliente já entrou em contato sobre isso antes?"),
},
Vale notar um detalhe específico do domínio bancário aqui: no atendimento de e-commerce genérico, um sinal clássico de escalonamento é "o cliente contestou a cobrança com o banco dele". Isso não faz sentido no meu cenário, porque eu sou o banco: não existe um terceiro para o cliente contestar comigo a cobrança que eu mesmo fiz. O sinal equivalente, real, é o cliente mencionar Procon ou uma reclamação formal no Banco Central. Adaptar o padrão a um domínio nunca é só trocar nomes de variável; é repensar se cada pergunta ainda faz sentido no novo contexto.
score: quando preciso medir intensidade, não apenas presença
Uso score quando a resposta não é binária, mas gradual, com níveis explicitamente descritos. 2-perguntas/02-intensidade-da-frustracao/002-frustracao-com-score.ts:
frustracao: score("Quão frustrado está o cliente na `mensagem`?", [
  "Não está frustrado. Só está pedindo ajuda.",
  "Está desapontado ou incomodado, mas ainda educado.",
  "Está com forte irritação, fazendo reclamações ou ameaças.",
]),
Nunca confundo noul com score ao formular uma pergunta para o Jev. noul responde "isso é verdade ou não". score responde "com que intensidade isso é verdade". Tratar os dois como intercambiáveis é um erro comum que degrada a qualidade do sinal que chega ao código: comparar 2-perguntas/02-intensidade-da-frustracao/001-frustracao-com-noul.ts (que trata frustração como algo binário) com o arquivo de score acima deixa essa perda de sinal visível.
Evitar perguntas compostas
2-perguntas/03-sinais-de-escalonamento/003-condicao-composta.ts compara, lado a lado, uma pergunta composta com sua versão decomposta:
questions: {
  irritadoEQuerEstorno: noul("O cliente está irritado e pedindo um estorno?"),
  estaIrritado: noul("O cliente está irritado na `mensagem`?"),
  querEstorno: noul("A `mensagem` pede um estorno?"),
},
Não pergunto ao Jev "o cliente está irritado E pedindo estorno" numa única pergunta quando as duas informações têm usos diferentes no código a seguir. Decomponho em julgamentos atômicos e deixo o código combinar as respostas com peso e lógica explícita. Uma pergunta composta esconde a lógica de decisão dentro do julgamento do Jev, exatamente o que eu quero evitar.
Requisições em lote
2-perguntas/05-triagem-completa-em-uma-chamada/001-uma-chamada-por-pergunta.ts e 002-todas-em-uma-chamada.ts fazem exatamente as mesmas sete perguntas sobre o mesmo chamado: a diferença é que o primeiro dispara uma chamada por pergunta, e o segundo envia todas de uma vez:
const { answers, usage } = await client.systemOne({
  state,
  questions: {
    time: choice(/* ... */),
    frustracao: score(/* ... */),
    eUrgente: noul("A `mensagem` diz que o problema precisa ser resolvido rapidamente?"),
    temDefeito: noul("A `mensagem` descreve um cartão com defeito?"),
    jaTentouResolver: noul("O cliente já tentou resolver o problema por conta própria?"),
    querEstorno: noul("A `mensagem` pede um estorno?"),
    foiCobradoErrado: noul("Se a `mensagem` for sobre uma cobrança, o cliente diz que foi cobrado incorretamente?"),
  },
});
Todas essas perguntas usam o mesmo estado e são independentes entre si, então envio todas numa única chamada ao Jev. O arquivo mede e imprime o tempo total e os tokens de entrada, e a diferença entre as duas versões não é sutil quando o volume de chamados é alto.
Parte 3: Uso das Respostas no Código
Aqui está o ponto que separa uma integração responsável do Jev de uma irresponsável: o Jev julga, o código decide. 3-respostas/01-roteamento-de-chamados-por-regra/001-rotear-chamados.ts mostra isso com um roteador real:
const { answers } = await client.systemOne({
  state: { mensagem: chamado.mensagem },
  questions: {
    intencao: choice("O que o cliente na `mensagem` precisa?", {
      cartao_com_defeito: "Um cartão que o cliente possui não está funcionando corretamente.",
      status_da_emissao: "Uma atualização sobre onde está uma emissão ou segunda via.",
      cancelamento: "Cancelar um cartão que funciona, mas o cliente não quer mais.",
      outro: "Qualquer outra coisa.",
    }),
    variosProblemas: noul("A `mensagem` descreve vários problemas separados?"),
  },
});

let rota = "Enviar para a fila geral";

if (answers.variosProblemas.noul >= 0.8) {
  rota = "Enviar para um atendente";
} else if (answers.intencao.choice === "cartao_com_defeito") {
  rota =
    chamado.cartao === "Aurora Black" && dentroDeUmAno(chamado.emitidoEm)
      ? "Enviar segunda via gratuita"
      : "Enviar para um atendente";
} else if (answers.intencao.choice === "status_da_emissao") {
  rota = "Responder com o link de rastreio";
} else if (answers.intencao.choice === "cancelamento") {
  rota = "Enviar instruções de cancelamento por e-mail";
}
Repare que dentroDeUmAno e a comparação chamado.cartao === "Aurora Black" são constantes e regras de negócio, não decisões do Jev. Elas podem e devem ser ajustadas pela área de produto ou de risco, versionadas e testadas, sem tocar em uma única pergunta feita ao Jev.
Numa decisão com maior efeito financeiro, como decidir se um estorno sai automaticamente ou vai para um analista, esse cuidado com "quem decide o quê" fica mais estrito ainda. Uma classificação de intenção como cartao_com_defeito responde a pergunta "o que está acontecendo com o cliente?"; ela não responde "esse chamado está elegível para um efeito financeiro automático?". São perguntas diferentes, e tratá-las como a mesma coisa é o erro mais comum nesse tipo de decisão. Separo em três camadas:
- Jev julga a alegação, não a elegibilidade: "o cliente está pedindo um estorno?" (
querEstorno), "o cliente diz que foi cobrado incorretamente?" (foiCobradoErrado). - O sistema verifica fatos que já possui, sem chamar o Jev de novo: a transação existe e está contabilizada (
status === "posted", não pendente nem já estornada)? o valor está dentro do limite para ação automática? - O Policy Engine combina as duas coisas e só então autoriza a ação automática ou escala para um analista: a política (limite, se a automação está habilitada para esse produto) é uma regra de negócio versionada, nunca um julgamento do Jev.
interface Transacao {
  status: "pending" | "posted" | "reversed";
  valor: number;
}

interface PoliticaDeEstorno {
  permiteEstornoAutomatico: boolean;
  limiteAutomatico: number;
}

function decidirAcaoEstorno(
  answers: { querEstorno: { noul: number }; foiCobradoErrado: { noul: number } },
  transacao: Transacao,
  politica: PoliticaDeEstorno,
) {
  // Elegibilidade = julgamento do Jev (o que o cliente alega) E fatos do
  // sistema (o que a transação e a política permitem). Nenhum dos dois
  // decide por si só.
  const elegivel =
    answers.querEstorno.noul >= 0.95 &&
    answers.foiCobradoErrado.noul >= 0.95 &&
    transacao.status === "posted" &&
    politica.permiteEstornoAutomatico &&
    transacao.valor <= politica.limiteAutomatico;

  if (elegivel) {
    return {
      acao: "estornar_automaticamente",
      automatica: true,
      motivoAuditoria:
        `Julgamento: querEstorno ${answers.querEstorno.noul.toFixed(2)}, ` +
        `foiCobradoErrado ${answers.foiCobradoErrado.noul.toFixed(2)}. ` +
        `Transação ${transacao.status}, valor dentro do limite automático de ${politica.limiteAutomatico}.`,
    };
  }
  if (answers.querEstorno.noul >= 0.6 || answers.foiCobradoErrado.noul >= 0.6) {
    return { acao: "confirmar_com_cliente", automatica: false };
  }
  return {
    acao: "escalar_para_analista",
    automatica: false,
    motivoAuditoria: "Confiança insuficiente ou transação fora dos critérios de elegibilidade automática.",
  };
}
O limiar 0.95 acima só é confiável se tiver sido calibrado, não apenas testado em regressão. Regressão garante que a resposta esperada continua vindo para os casos do golden dataset. Calibração garante que "confiança 0.95" corresponde, na prática, a algo próximo de 95% de acerto real nesse tipo de caso. São verificações diferentes: rodo as duas, mas trato a segunda como pré-requisito para fixar qualquer limiar usado em decisão financeira automática, não como um extra.
Esse desenho de três faixas (automático, confirmar, escalar) é um padrão com nome: abstenção seletiva. O sistema tem permissão explícita para dizer "não tenho confiança suficiente para decidir sozinho" em vez de forçar uma automação de 100% dos casos.
O limiar de confiança (0.95) é uma constante de negócio, versionável e testável, nunca uma decisão implícita do Jev. 3-respostas/02-confianca-para-agir-automaticamente/001-confianca-do-choice.ts mostra a mesma lógica de limiares aplicada ao roteamento por time, e 3-respostas/03-quanto-de-confianca-para-estornar/001-responder-ou-estornar.ts mostra como o limiar deveria mudar conforme o risco da ação: sugerir uma resposta pode exigir confiança 0.5, mas executar um estorno automaticamente exige 0.95.
Priorização composta (composite scoring)
Um julgamento do Jev sozinho raramente é suficiente para priorizar uma fila de atendimento. 3-respostas/04-fila-priorizada-de-chamados/001-prioridade-com-peso.ts combina os julgamentos de impacto e frustração com sinais que o sistema já possui, sem precisar de nova chamada ao Jev, e mostra como a mesma resposta pode gerar filas diferentes dependendo do peso de negócio escolhido:
function ordenar(pesos: Pesos) {
  return chamados
    .map((chamado) => {
      const prioridade =
        chamado.impacto * pesos.impacto +
        chamado.frustracao * pesos.frustracao +
        (chamado.cartao === "Aurora Black" ? 1 : 0) * pesos.cartao +
        Math.min(chamado.horasEsperando / 24, 1) * pesos.espera;
      return { id: chamado.id, mensagem: chamado.mensagem, prioridade };
    })
    .sort((a, b) => b.prioridade - a.prioridade);
}

// Mesmas respostas do Jev, duas prioridades de negócio diferentes, nenhuma chamada nova.
ordenar({ impacto: 0.5, frustracao: 0.1, cartao: 0.2, espera: 0.2 }); // foco em produto
ordenar({ impacto: 0.2, frustracao: 0.4, cartao: 0.1, espera: 0.3 }); // foco em relacionamento
Isso é reutilização de julgamento, não repetição de chamada ao Jev. O Jev julgou uma vez (impacto, frustração), o código explora esse julgamento de múltiplas formas.
Tratamento de falha do Jev
decidirAcaoEstorno assume que client.systemOne sempre responde. Em produção, isso falha: timeout, rate limit, erro 5xx, indisponibilidade do serviço. Para decisões de maior risco financeiro, a regra é fail closed: se o Jev não responde, o código nunca assume uma resposta implícita, ele escala para análise humana. 3-respostas/05-estorno-com-jev-indisponivel/001-fail-closed.ts mostra essa lógica aplicada ao mesmo roteador de estorno:
try {
  const { answers } = await client.systemOne({
    state: { mensagem: chamado.mensagem },
    questions: {
      querEstorno: noul("A `mensagem` pede um estorno?"),
      foiCobradoErrado: noul("O cliente diz que foi cobrado incorretamente?"),
    },
  });
  // ... mesma lógica de elegibilidade de decidirAcaoEstorno ...
} catch (erro) {
  // Fail closed: indisponibilidade do Jev nunca vira decisão automática.
  return {
    acao: "escalar_para_analista",
    automatica: false,
    motivoAuditoria: `Jev indisponível (${(erro as Error).message}). Nenhuma decisão financeira automática foi tomada.`,
  };
}
A mesma preocupação vale para o efeito da decisão, não só para o julgamento que a alimenta: se o orchestrator reenviar o mesmo chamado depois de um timeout na confirmação, o código não pode estornar duas vezes. 3-respostas/06-evento-de-decisao-com-chave-idempotente/001-registrar-decisao.ts registra cada decisão sob uma chave de idempotência (refund:${ticket_id}): um retry com o mesmo chamado devolve o evento já registrado, em vez de executar a ação de novo.
Arquitetura de Referência
O padrão inteiro só funciona de forma segura em produção se estiver encaixado numa arquitetura de camadas, e não como uma chamada solta de API dentro de um endpoint.
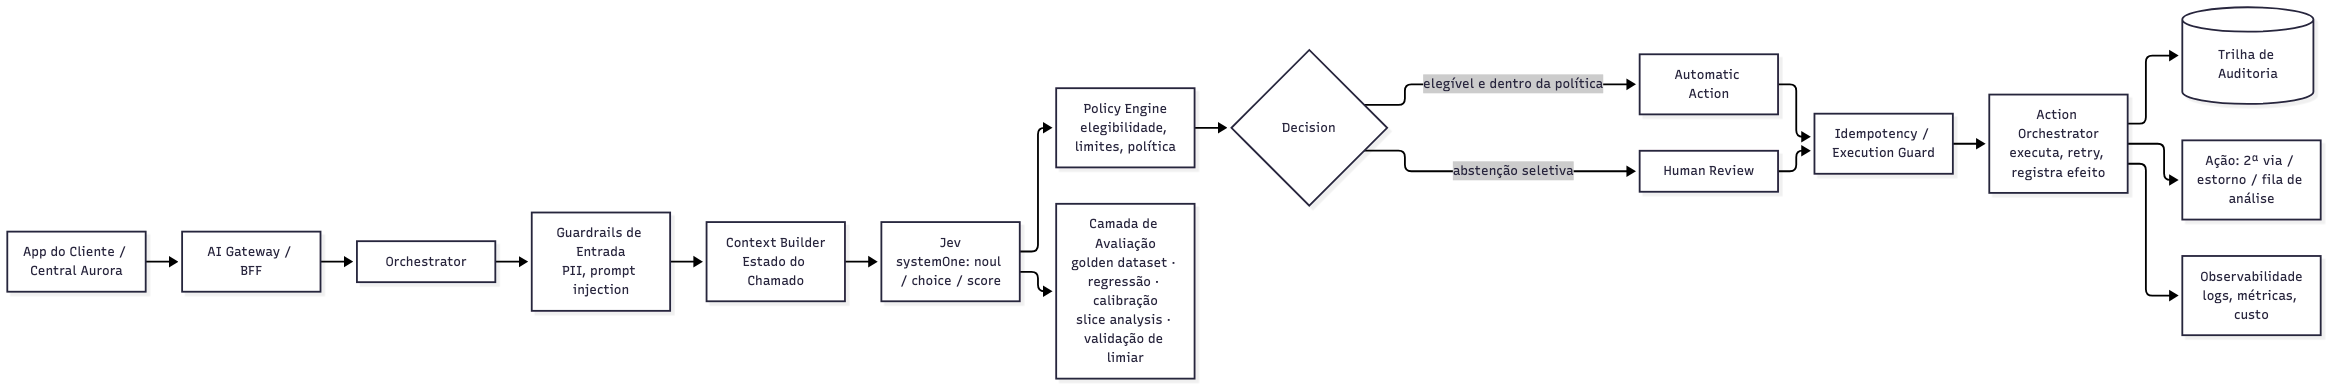
Repare que não há uma camada própria de "roteamento de modelo" ou de "parser de saída estruturada" entre o Context Builder e o Jev: ele já entrega isso pronto. Cada chamada a client.systemOne já devolve noul, choice ou score tipados: não preciso construir nem manter um parser de JSON Schema ou de function calling por cima de um LLM genérico, nem decidir qual modelo por trás usar para qual pergunta. Esse encapsulamento, e não só o padrão arquitetural, é o valor concreto de usar o Jev aqui.
O que era um único bloco "Motor de Decisão" nas primeiras versões deste artigo hoje é, corretamente, três responsabilidades separadas: a mesma separação que decidirAcaoEstorno implementa em código, agora visível no diagrama. O Policy Engine só aplica política de negócio (limiares, produto, se a automação está habilitada) sobre o julgamento do Jev e os fatos que o sistema já tem; ele decide "autorizar automaticamente" ou "escalar", nunca executa nada. O Action Orchestrator é quem executa de fato: chama as APIs internas, garante idempotência (via o Idempotency/Execution Guard, que impede um retry de estornar duas vezes), controla retry, e registra o efeito na trilha de auditoria. Separar os dois importa porque eles mudam por razões diferentes: a política muda quando a área de risco ajusta um limiar; o orchestrator muda quando a integração com o sistema de pagamentos muda. Misturar as duas responsabilidades num único "Motor de Decisão" funciona para um protótipo, mas some justamente a rastreabilidade que a seção de riscos abaixo exige.
O ponto que costuma ser negligenciado é a camada de Avaliação. Não considero esse sistema pronto para produção só porque as respostas "parecem boas" em teste manual. Ela precisa de um golden dataset de chamados reais e anonimizados com o rótulo correto já conhecido (regressão), de confirmar que "confiança 0.95" corresponde a ~95% de acerto real (calibração; ver a seção anterior), de olhar a taxa de acerto separada por subgrupo em vez de só a média geral (slice analysis, para pegar viés que a média esconde), e de validar cada limiar usado numa decisão automática antes de subir para produção. Pular qualquer uma dessas quatro verificações e confiar só nas outras é como testar unicamente o caminho feliz de um sistema de pagamentos: passa em teste manual e falha exatamente no caso que importa.
Riscos Específicos do Contexto Bancário
Este padrão, aplicado a atendimento genérico, já exige cuidado. Aplicado a decisão financeira regulada, exige mais:
Auditabilidade regulatória. Em decisões automatizadas que afetam interesses do titular, a arquitetura precisa ser concebida considerando os requisitos de transparência, revisão e rastreabilidade que a LGPD aplica ao tratamento automatizado de dados pessoais, incluindo o direito do titular de solicitar informação clara sobre os critérios usados. O motivoAuditoria do decidirAcaoEstorno existe para sustentar essa explicação, e guardo como evento imutável, não como log volátil.
Versionamento de modelo atrelado a limiar. Quando um limiar de negócio como 0.95 depende do comportamento de uma versão específica do Jev, eu fixo essa versão nas chamadas que alimentam decisão automática (jev-1.x em vez de jev-latest) e trato a troca de versão do modelo com o mesmo rigor de regressão que já aplico a mudança de pergunta. Sem isso, uma atualização do modelo pode descalibrar um limiar em produção sem que nenhuma linha de código tenha mudado.
Explicabilidade para o cliente e para o órgão regulador. "Confiança 0.95" não é uma explicação aceitável para um cliente que teve o estorno negado. O motivoAuditoria precisa depois virar uma explicação legível por humano, não apenas um campo técnico.
Viés no julgamento. O Jev pode aprender a associar padrões de linguagem, forma de escrever, uso de gírias regionais, a um confidence menor no mesmo julgamento, o que é discriminatório e inaceitável numa decisão de crédito ou de disputa financeira. Isso precisa ser um critério ativo de avaliação, testado com golden dataset diversificado, não uma suposição de que "o Jev é neutro".
PII no estado enviado ao Jev. Em vez de montar o estado com os dados completos do cliente e da transação e mascarar depois, eu construo um contexto explicitamente permitido: um objeto com apenas os campos que a pergunta em questão precisa, nunca a entidade completa do banco de dados. A diferença é sutil no código mas importante na superfície de exposição: um allowlist de campos é auditável antes do envio, uma máscara aplicada depois é uma correção que pode falhar silenciosamente se um campo novo for adicionado à entidade original sem que ninguém lembre de mascará-lo.
Quando não usar o Jev
Não uso o Jev para decisões que exigem determinismo regulatório absoluto, como cálculo de juros, aplicação de tarifas ou verificação de limite de crédito disponível. Nesses casos, o Jev pode, no máximo, auxiliar na comunicação ou na triagem inicial, nunca substituir a regra determinística que já existe e que já é auditável por natureza. A linha que separo sempre é: julgamento de conteúdo não estruturado, sim, com o Jev; cálculo ou regra de negócio determinística, não.
Rode o Jev você mesmo
Cada trecho de código deste artigo existe, de verdade, no repositório de demonstração, organizado nas mesmas três partes deste texto:
npm ci
cp .env.example .env    # adicione sua chave de API da TypeSafe para autenticar as chamadas ao Jev
npm run scenario 1-estado/01-chamado-cartao-com-defeito/002-objeto-estruturado.ts
npm run scenario 3-respostas/04-fila-priorizada-de-chamados/001-prioridade-com-peso.ts
Os resultados são reais, não simulados: o Jev responde de verdade, e os números variam levemente entre execuções. Os limiares e pesos usados aqui são exemplos; escolha os seus testando mensagens reais do seu próprio atendimento.
Laya e Kev: as alternativas open source mais próximas do Jev
Sep 27, 2026 · @Alexsander
O que são Laya e Kev
São dois modelos de decisão open source, construídos para reproduzir o paradigma operacional e o contrato de decisões tipadas popularizado pelo Jev, da TypeSafe: recebem um estado e perguntas tipadas (choice, score, noul) e devolvem uma resposta estruturada com probabilidade calibrada, sem gerar texto livre.
Laya é um modelo não autoregressivo, construído sobre encoders bidirecionais (ModernBERT-large no checkpoint em inglês, mmBERT-base no multilíngue), treinado especificamente para decisão tipada. Publica três checkpoints: um de 421M para inglês, um de 322M multilíngue cobrindo mais de 100 idiomas, e um segundo de 421M especializado no benchmark de decisões tipadas. Um roteador interno detecta o idioma da entrada antes da inferência e seleciona o checkpoint correto. O projeto distribui também o próprio pipeline de treino (RLCD, calibração de temperatura, avaliação, publicação no Hugging Face), com portas para MLX e Core ML no Apple Silicon.
Kev, de Jared Palmer, é uma família de modelos construída sobre o Qwen3.5, usando adapters LoRA e uma cabeça de leitura (readout head) treinada para devolver as distribuições de probabilidade de choice, score e noul. Está disponível em três tamanhos: 0,8B, 4B e 9B parâmetros. Kev adota o mesmo formato de requisição System One do Jev, o que permite apontar o SDK Python oficial da TypeSafe para um servidor Kev local trocando apenas a base_url.
Por que são as implementações mais próximas do paradigma do Jev
Existem outras réplicas abertas (SemIf, jeff, OpenJev, LocalJev, NanoJev), mas todas reaproveitam um modelo de propósito geral já existente e o encaixam no formato de decisão tipada por fora, lendo probabilidade dos logits ou envolvendo um classificador genérico numa API compatível.
Laya e Kev seguem o caminho oposto: são modelos dedicados, treinados especificamente para o problema de decisão tipada, do mesmo jeito que o Jev foi. É essa escolha arquitetural, e não apenas a existência de um endpoint compatível, que os coloca como as implementações mais próximas do contrato funcional apresentado pelo Jev.
Kev tem uma vantagem adicional de integração: adota o schema System One nativo do Jev, então qualquer aplicação já integrada ao SDK oficial da TypeSafe troca de provedor sem reescrever a camada de chamada, apenas trocando a URL base.
No benchmark próprio de 2.000 decisões que a Laya publica, o checkpoint laya-typed-decisions reporta 0,766 de acurácia contra 0,727 do Jev hospedado nesse mesmo conjunto. Não tomaria isso como "Laya é melhor que o Jev": é um resultado dentro do benchmark autoral da Laya, não uma avaliação independente e neutra entre os dois. Ainda assim, é um dado relevante o suficiente para mostrar que a distância de qualidade entre a opção fechada e a aberta, nesse ponto específico, já não é óbvia.
São open source e gratuitas?
Sim, os dois são licenciados sob Apache-2.0, tanto o código quanto os pesos publicados. Isso significa que não há custo de licenciamento para usar, modificar, redistribuir ou até fazer fine-tuning, inclusive para uso comercial.
Uma distinção importante para não gerar expectativa errada: gratuito de licença não é o mesmo que gratuito de operação. Rodar Laya ou Kev localmente elimina a cobrança por token do Jev (US$ 0,042 por milhão de tokens de entrada, saída sem custo), mas exige infraestrutura própria, GPU ou Apple Silicon para os tamanhos maiores, energia, manutenção e, se a demanda crescer, escalonamento. O ponto de equilíbrio entre pagar por chamada de API e manter infraestrutura própria depende do volume de decisões por dia da aplicação.
O próprio Jev, em contraste, é fechado: a TypeSafe não publicou pesos nem receita de treino. Laya e Kev não são cópias desses pesos, são reimplementações independentes que aprenderam a se comportar de forma equivalente.
Uma ressalva adicional: a licença Apache-2.0 cobre o código e os artefatos dos modelos, mas datasets usados no treino costumam carregar licenças próprias, separadas da licença do modelo. Isso precisa ser avaliado à parte antes de qualquer uso comercial ou regulado, e não pode ser assumido como resolvido só porque o modelo em si é Apache-2.0.
Comparativo técnico
| Critério | Laya | Kev |
|---|---|---|
| Autor | NandhaKishorM | Jared Palmer |
| Arquitetura | Encoder não autoregressivo (ModernBERT-large / mmBERT-base) | Qwen3.5 + adapters LoRA + readout head |
| Tamanhos | 421M (inglês), 322M (multilíngue), 421M (decisão tipada) | 0,8B, 4B, 9B |
| Licença | Apache-2.0 | Apache-2.0 |
| Compatibilidade de API | Perguntas no estilo Jev (choice, score, noul) | Schema System One nativo do Jev |
| Multilíngue | Sim, checkpoint dedicado para 100+ idiomas | Não é o foco declarado |
| Apple Silicon | MLX e Core ML | Roda em Apple Silicon |
| Acurácia publicada | 0,766 no conjunto de 2.000 decisões da própria Laya | 0,837 (Kev-4B) e 0,852 (Kev-9B) no conjunto de transferência do próprio Kev |
| Pipeline de treino próprio | Sim (RLCD, calibração de temperatura, avaliação, publicação no Hugging Face) | Sim (pipeline de dados, avaliação, treino) |
Um ponto de rigor técnico sobre a linha de acurácia: os dois números vêm de conjuntos de avaliação próprios de cada projeto, não de um benchmark compartilhado e padronizado. Não são diretamente comparáveis entre si, e nenhum dos dois substitui rodar o seu próprio conjunto de teste na distribuição real da sua aplicação.
Recomendações
A escolha entre os dois depende da necessidade dominante, não de qual é "melhor" em abstrato:
| Necessidade | Opção a investigar |
|---|---|
| Compatibilidade direta com o schema System One | Kev |
| PT-BR / multilíngue como requisito central | Laya (checkpoint multilíngue) |
| Implantação em edge / Apple Silicon | Laya |
| Já trabalha com Qwen e LoRA internamente | Kev |
| Modelo pequeno dedicado, sem dependência de backbone generativo | Laya (typed-decisions) |
| Dado sensível, execução on-premises | Ambos atendem |
| Substituição futura Jev por self-hosted mantendo o contrato de API | Kev tem vantagem, pelo schema nativo |
Antes de levar qualquer um dos dois para produção, principalmente num domínio regulado como o bancário, eu trataria três pontos como não negociáveis:
- Rodar um golden dataset próprio, anotado com a distribuição real de dados da aplicação, porque os números de acurácia publicados vêm de conjuntos de avaliação de cada projeto, não do meu domínio.
- Avaliar a curva de calibração de confiança, não só a acurácia, já que decisões automáticas dependem de o modelo saber declarar incerteza de forma honesta.
- Confirmar os termos de licença Apache-2.0 dentro do contexto jurídico e de compliance da empresa antes de uso comercial, incluindo a licença dos datasets de treino, mesmo sendo uma licença permissiva.
Se fizer sentido, especializar Laya ou Kev com fine-tuning (RLCD no caso do Laya, LoRA adicional no caso do Kev) sobre dados anonimizados reais do domínio é o passo natural seguinte, e mantém o dado sensível dentro do perímetro da empresa durante todo o processo.
Um último ponto arquitetural, que vale para os três (Jev, Kev e Laya): nenhum deles deveria entrar como motor autônomo de decisão financeira ou antifraude só porque devolve uma probabilidade calibrada. O papel correto desses modelos é fornecer evidência probabilística para uma policy engine determinística, que combina esse julgamento com regras de negócio, dados já conhecidos do sistema e, quando necessário, revisão humana, exatamente a separação que sustenta toda a arquitetura de triagem de disputas que desenhei antes.


